1. Czym jest przestrzenne wspomaganie decyzji?
W działalności produkcyjnej, logistycznej i na rynku nieruchomości przemysłowych wiele decyzji strategicznych ma charakter przestrzenny. Dotyczy to wyboru regionu dla nowego zakładu, selekcji konkretnej działki, oceny dostępu do infrastruktury i rynku pracy, rozmieszczenia obiektów w sieci dystrybucyjnej, a także porównywania nieruchomości przeznaczonych do zakupu lub rozbudowy. Położenie wpływa w tych przypadkach na koszty, czas transportu, dostępność zasobów, ryzyko inwestycyjne i możliwości dalszego rozwoju przedsiębiorstwa.
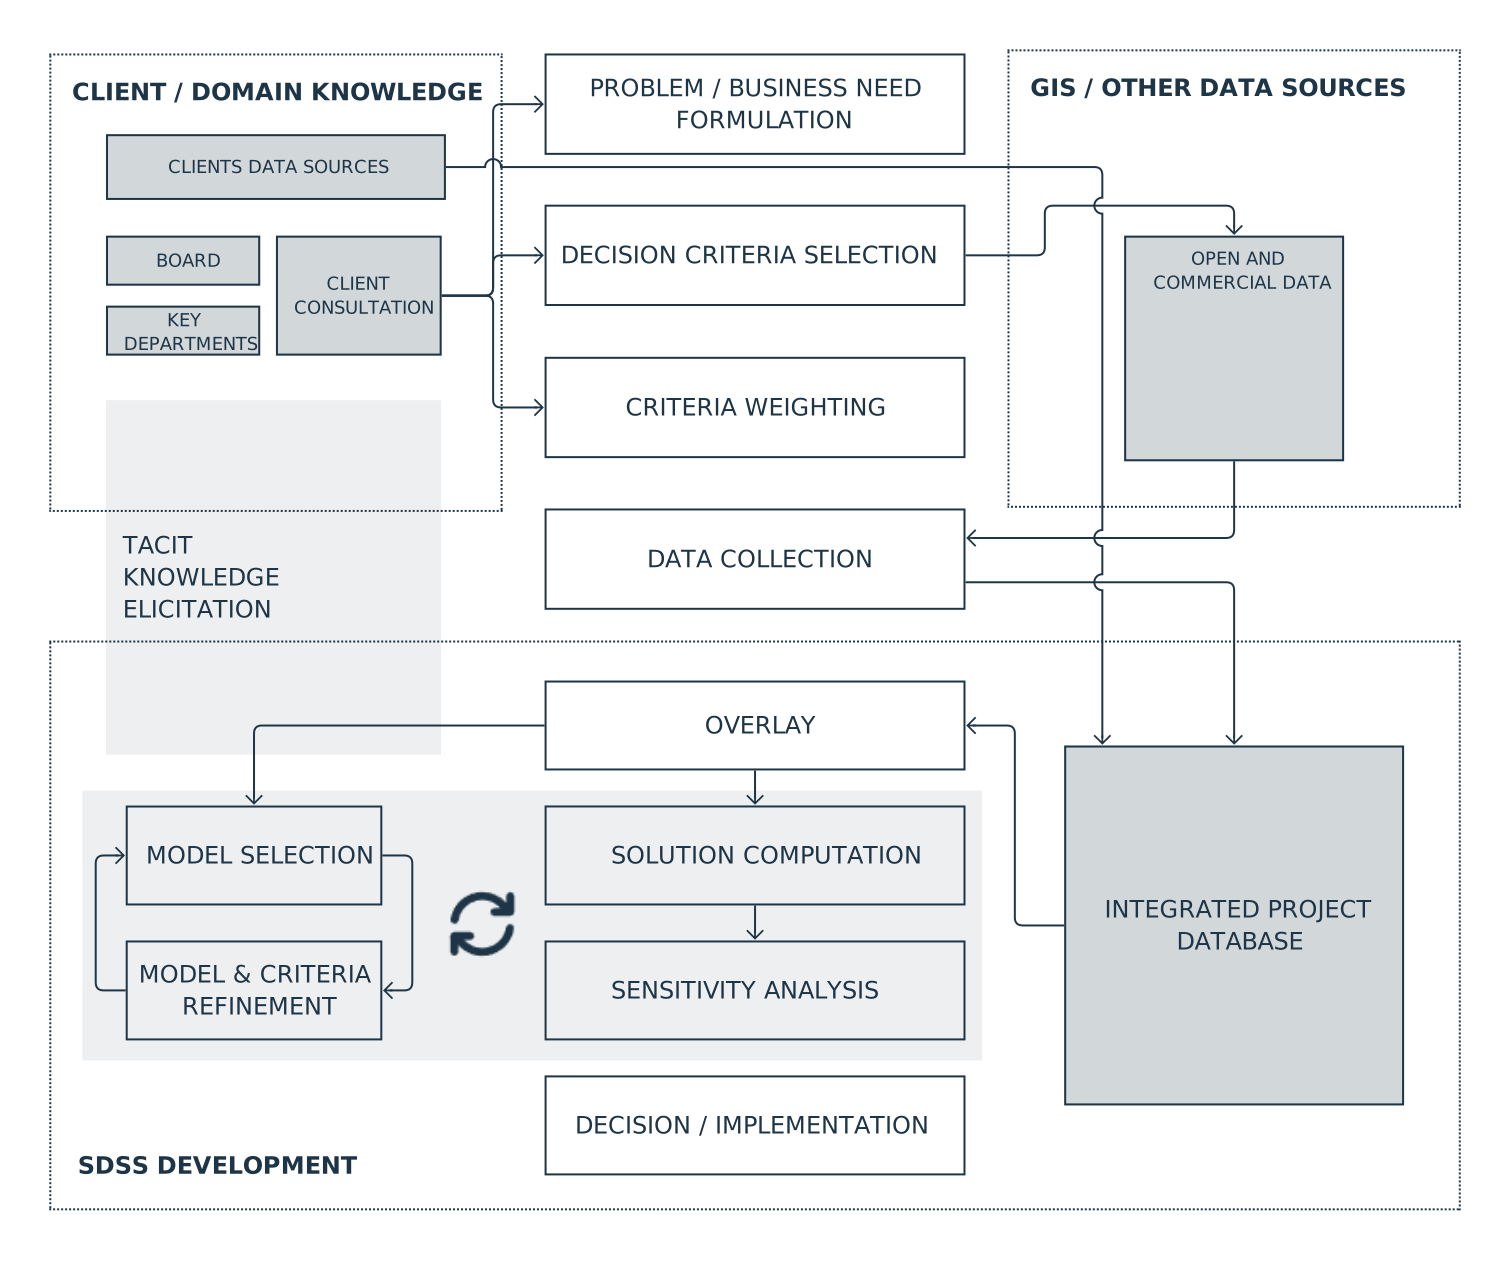
System informacji geograficznej (GIS) służy do gromadzenia danych, łączenia ich przestrzennie, analizowania odległości, sąsiedztwa i dostępności oraz przedstawiania rezultatów na mapie. Nie każda analiza wykonana w GIS jest jednak systemem wspomagania decyzji. Przestrzenny system wspomagania decyzji (Spatial Decision Support System, SDSS) łączy dane przestrzenne i nieprzestrzenne, funkcje analityczne GIS oraz model problemu decyzyjnego. Jego zadaniem jest nie tylko opis sytuacji, lecz przede wszystkim porównanie wariantów, rozpoznanie kompromisów między nimi i sprawdzenie konsekwencji przyjętych założeń.[1]
Ta różnica jest istotna z punktu widzenia praktyki biznesowej. Mapa dostępnych działek stanowi dobre źródło informacji, ale sama nie odpowiada na pytanie, która lokalizacja najlepiej realizuje cele inwestora. Model prognozujący czynsze opisuje rynek, lecz nie rozstrzyga jeszcze, czy dana nieruchomość powinna zostać kupiona. Wartość SDSS polega na zbudowaniu spójnego procesu prowadzącego od informacji do decyzji.
2. Od danych do decyzji
Punktem wyjścia jest rozpoznanie problemu, a nie wybór oprogramowania lub algorytmu. W projekcie inwestycyjnym trzeba zwykle połączyć informacje pochodzące z wielu źródeł: dane o działkach i budynkach, koszty zakupu i realizacji inwestycji, parametry transportowe i infrastrukturalne, lokalizację klientów i dostawców, informacje o rynku pracy, uwarunkowania planistyczne, ograniczenia formalnoprawne oraz dane rynkowe.
Dla potrzeb projektu informacje te dzieli się na kilka grup tematycznych:
- nieruchomość i działka,
- koszty i parametry inwestycji,
- transport i infrastruktura,
- rynek i otoczenie przemysłowe,
- rynek pracy i popyt,
- uwarunkowania planistyczne i instytucjonalne.
Czas nie stanowi odrębnej kategorii danych, lecz dodatkowy wymiar każdej z nich. Cenę gruntu, dostępność pracowników, przepustowość infrastruktury, czynsze magazynowe czy sposób zagospodarowania terenu analizuje się jako stan w określonym momencie albo jako zmienne obserwowane w szeregu czasowym.
Szczególną cechą SDSS jest łączenie danych pozostających w posiadaniu przedsiębiorstwa z informacjami zewnętrznymi. Keenan i Jankowski pokazują to na prostym przykładzie analizy lokalizacyjnej: rozmieszczenie obecnych klientów stanowi punkt wyjścia, natomiast uzupełnienie go o sieć drogową, dane demograficzne i informacje o infrastrukturze pozwala pełniej opisać warunki decyzji.[1]
Nie wszystkie informacje pełnią tę samą funkcję. Część określa warunki bezwzględne, na przykład minimalną powierzchnię działki, wymagane przeznaczenie terenu, dopuszczalną odległość od autostrady czy dostęp do odpowiedniej mocy przyłączeniowej. Inne służą do porównywania lokalizacji, które spełniły warunki podstawowe: koszt gruntu, dostępność pracowników, odległość od odbiorców, ryzyko planistyczne albo możliwość przyszłej rozbudowy. Kolejna grupa danych jest potrzebna do prognozowania, optymalizacji lub analizy ryzyka.
Nie istnieje zatem jeden uniwersalny przebieg analizy. W zależności od problemu proces obejmuje rozpoznanie celów biznesowych, określenie ograniczeń, przygotowanie danych, wyłonienie wariantów, ustalenie kryteriów oceny, porównanie lub optymalizację wariantów, analizę wrażliwości i przygotowanie rekomendacji. Zakres oraz kolejność tych etapów wynikają z charakteru decyzji.
3. SDSS powstaje wspólnie z Klientem
Dobrze zaprojektowany system wspomagania decyzji nie jest gotowym produktem przygotowanym przez analityka i przekazanym Klientowi po zakończeniu obliczeń. Powstaje w stałej współpracy z organizacją, której decyzje ma wspierać. Geertman i Stillwell zwracają uwagę, że rozwój systemów wspomagania wynika z potrzeb użytkowników, a nie z dostępności określonej technologii. Podkreślają również zależność takich systemów od kontekstu, w którym są stosowane.[2]
W przypadku firmy produkcyjnej lub logistycznej nie wystarcza rozmowa z Zarządem czy z autorami strategii biznesowej. Ich wiedza jest niezbędna do określenia celów inwestycji i akceptowalnego poziomu ryzyka, ale znaczna część informacji potrzebnych do właściwego opisania procesów znajduje się niżej w strukturze organizacji.
Brygadzista w magazynie często zna operacje powodujące codzienne zatory, choć problem nie występuje w oficjalnych raportach. Kierownik logistyki zna rzeczywiste ograniczenia tras, których nie pokazuje standardowa analiza czasu przejazdu. Dział zakupów wie, których dostawców cechuje niezawodność, a którzy są w stanie natychmiast zwiększyć wolumen. Dział utrzymania ruchu wskazuje zależności między układem budynku a kosztami serwisu, których nie widać w dokumentacji projektowej.
To wiedza ukryta — wynikająca z doświadczenia i codziennej praktyki, lecz nieutrwalona w bazach danych ani procedurach. Dobry analityk interesuje się nią równie mocno jak danymi liczbowymi. Jego zadaniem nie jest jedynie przetworzenie informacji dostarczonych przez Klienta, lecz również wydobycie tej wiedzy, uporządkowanie jej i przełożenie na kryteria oraz ograniczenia modelu.
Proces ma charakter iteracyjny. Na początku formułuje się problem i identyfikuje dane. Następnie weryfikuje się, czy sposób opisania sytuacji odpowiada temu, jak przedsiębiorstwo faktycznie działa. Pierwsze wyniki omawia się z osobami odpowiedzialnymi za poszczególne procesy. Ujawnione braki informacji, sprzeczne założenia albo nieoczekiwane konsekwencje prowadzą do korekty modelu. Taka współpraca nie jest dodatkiem do analizy, lecz częścią metody.
Dobrze przeprowadzony proces pełni również funkcję organizacyjnie „terapeutyczną” — w sensie diagnostycznym i integracyjnym. Wspólne definiowanie kryteriów ujawnia różnice między tym, co firma deklaruje jako priorytet, a tym, co rzeczywiście ogranicza jej działalność. Bywa, że dział logistyki i dział zakupów inaczej oceniają tych samych dostawców, Zarząd inaczej rozumie znaczenie elastyczności produkcji niż zespół operacyjny albo dwa działy korzystają z różnych wersji tych samych danych.
Wartością projektu nie jest więc wyłącznie końcowy model. Sam proces jego budowy porządkuje wiedzę o przedsiębiorstwie, wymusza sformułowanie założeń, ujawnia problemy, które wcześniej pozostawały rozproszone, oraz tworzy wspólny język dla osób odpowiedzialnych za różne etapy operacji Klienta. W efekcie SDSS służy nie tylko konkretnej decyzji inwestycyjnej, lecz również usprawnia komunikację między działami.
4. Wstępna selekcja lokalizacji i analiza wielokryterialna
Najbardziej oczywistym zastosowaniem SDSS w sektorze przemysłowym jest wybór lokalizacji. Proces ten nie musi jednak rozpoczynać się od porównania gotowej listy działek. Jeżeli obszar poszukiwania obejmuje duży region lub kilka krajów, pierwszym zadaniem jest zwykle ograniczenie przestrzeni poszukiwań.
Na tym etapie GIS służy do wykluczenia terenów o niewłaściwym przeznaczeniu, niedostatecznej powierzchni, niewystarczającym dostępie do infrastruktury albo położonych poza przyjętym zasięgiem komunikacyjnym. Następnie oblicza się dostępność transportową, bliskość klientów i dostawców, położenie względem rynku pracy oraz inne wskaźniki istotne dla danego przedsięwzięcia.
Badanie Raada, Rajendran i Salimi dotyczące lokalizacji suchego portu dobrze pokazuje wieloetapowy charakter takiego procesu. Autorzy najpierw ustalili, które czynniki mają znaczenie dla lokalizacji, następnie wykorzystali dane przestrzenne do wskazania obszarów spełniających podstawowe warunki, a dopiero później porównali wyłonione miejsca z uwzględnieniem dodatkowych kryteriów.[3] Rozdzielenie (1) ograniczenia obszaru poszukiwań oraz (2) porównania wariantów, które pozostały po wstępnej selekcji, stanowi jedną z podstawowych zasad budowy tego typu systemu.
Kiedy realnych lokalizacji jest już kilka lub kilkanaście, przydatna staje się analiza wielokryterialna. Jej zadaniem jest uporządkowanie decyzji, w której trzeba uwzględnić kilka czynników i jednocześnie realizować kilka celów. Najtańszy grunt nie zapewnia najlepszego dostępu do pracowników; dobrze skomunikowana działka bywa trudna do rozbudowy; nieruchomość o dobrych parametrach technicznych może wiązać się z większym ryzykiem planistycznym.
Keenan i Jankowski wskazują analizę wielokryterialną jako jedną z najważniejszych grup metod wykorzystywanych w SDSS, szczególnie w problemach związanych z oceną przydatności terenu, poszukiwaniem lokalizacji i alokacją zasobów.[1] W praktyce jej wartość polega przede wszystkim na tym, że zmusza organizację do jawnego określenia, jakie kryteria bierze pod uwagę i jak rozumie kompromis między nimi.
W badaniu Shahparvariego i współautorów proces lokalizacyjny podzielono na kilka etapów. Najpierw na podstawie danych przestrzennych wskazano korzystne regiony. Następnie wyłoniono niewielką liczbę potencjalnych lokalizacji. W ostatnim etapie porównano je równocześnie pod względem wielu kryteriów i uszeregowano warianty.[4] Ten przykład dobrze pokazuje, że inne narzędzia służą wyszukiwaniu obszarów, inne selekcji kandydatów, a jeszcze inne ich końcowemu porównaniu.
5. Kiedy ranking działek nie wystarcza
Porównanie kilku znanych nieruchomości i poszukiwanie optymalnej lokalizacji to dwa różne problemy. W pierwszym przypadku warianty są już określone. W drugim lokalizacja sama jest przedmiotem obliczeń i często wiąże się z innymi decyzjami dotyczącymi sieci dostaw lub obsługi rynku.
W najprostszym modelu lokalizacyjnym poszukuje się takiego położenia zakładu, które ogranicza łączny koszt transportu surowców do fabryki oraz gotowych produktów do odbiorców. Murray, Church i Feng analizują trudniejszą sytuację: dla każdego z potrzebnych surowców istnieje kilku możliwych dostawców. Wybór dostawcy zależy od położenia zakładu, ponieważ zmienia się koszt transportu; jednocześnie wybór źródła zaopatrzenia wpływa na to, gdzie zakład powinien zostać zlokalizowany. Lokalizacji fabryki i organizacji zaopatrzenia nie rozpatruje się więc oddzielnie — model szuka korzystnej konfiguracji obu decyzji równocześnie.[5]
Różnica z punktu widzenia Zarządu jest zasadnicza. Analiza wielokryterialna odpowiada na pytanie: „która z pięciu analizowanych nieruchomości najlepiej odpowiada naszym potrzebom?”. Model optymalizacyjny odpowiada natomiast na pytanie: „gdzie powinien znaleźć się zakład, jeżeli równocześnie uwzględnimy źródła surowców, odbiorców, wolumeny przepływów i koszty transportu?”. Drugi problem nie jest bardziej szczegółowym rankingiem działek. Ma inną strukturę i nierzadko prowadzi do lokalizacji, której wcześniej nie było na żadnej krótkiej liście.
Znaczenie ma również sposób odwzorowania przestrzeni. W analizach logistycznych odległość w linii prostej często stanowi zbyt daleko idące uproszczenie. Jeżeli samochody poruszają się po określonej sieci drogowej, znaczenie mają rzeczywiste trasy, kierunkowość ulic, węzły i ograniczenia przejazdu. W jednym z analizowanych badań zastąpienie prostych odległości odległościami liczonymi po sieci drogowej lepiej odwzorowało faktyczne warunki transportu.[6] Przykład ten pokazuje, że poprawa jakości modelu wynika nie tyle z zastosowania bardziej złożonego algorytmu, ile z wierniejszego opisania rzeczywistego problemu.
6. Dane rynkowe jako źródło wiedzy o lokalizacji
Nie każda analiza przestrzenna prowadzi bezpośrednio do wyboru działki. Czasem ważniejsze jest zrozumienie, jakie czynniki rzeczywiście wpływają na zachowania firm lub na wartość nieruchomości.
Yang, Chen, Pan i Yuan analizowali czynniki związane z rozmieszczeniem obiektów logistycznych w Szanghaju. Uwzględnili m.in. gęstość zaludnienia, przeznaczenie terenów pod funkcje przemysłowe i magazynowe, odległość od centrum, portów, kolei towarowej i węzłów autostradowych oraz zagęszczenie zakładów przemysłowych.[7]
Wyniki pokazują, dlaczego nie należy traktować listy kryteriów jako uniwersalnej. W badanym przypadku bliskość kolejowych terminali towarowych była istotnie związana z lokalizacją nowych obiektów logistycznych, podczas gdy wpływ odległości od najbliższego węzła autostradowego był znacznie mniej wyraźny. Autorzy wiążą to z wysokim poziomem rozwoju sieci drogowej, który zmniejszał różnice dostępności między poszczególnymi częściami miasta.
Taka analiza nie służy bezpośrednio do wydania rekomendacji inwestycyjnej. Sprawdza natomiast, czy czynniki uznawane za ważne w modelu rzeczywiście różnicują rynek w danym regionie i okresie. Jej wyniki stanowią jedno ze źródeł wiedzy wykorzystywanej później przy budowie kryteriów decyzji.
7. Jak ustalać znaczenie kryteriów
Jednym z najważniejszych etapów analizy wielokryterialnej jest ustalenie, które kryteria są rzeczywiście istotne dla danego Klienta. Nie jest to zadanie czysto techniczne. Wagi wynikają z celów biznesowych, ograniczeń operacyjnych i doświadczenia osób odpowiedzialnych za poszczególne procesy.
Najprostszy wariant polega na tym, że uczestnicy projektu oceniają znaczenie poszczególnych kryteriów. Hammond i współautorzy zastosowali właśnie takie rozwiązanie przy budowie systemu wspomagania decyzji dla terenów poprzemysłowych. Lista kryteriów została przedstawiona przyszłym użytkownikom systemu, którzy oceniali każde z nich w skali od 1 do 10 w zależności od jego znaczenia dla określonego sposobu zagospodarowania. Średnie oceny wykorzystano następnie jako wagi w modelu.[8]
Inny interesujący przykład pochodzi z badania Öndena, Eldemira, Acara i Çancı dotyczącego lokalizacji centrów logistycznych w Stambule. Autorzy rozpoczęli od określenia kryteriów, następnie zebrali oceny uczestników związanych z sektorem transportowym i logistycznym, a wyniki wykorzystali do ustalenia znaczenia poszczególnych czynników w analizie przestrzennej. Co ważne, rozpatrywali również scenariusze odzwierciedlające punkt widzenia różnych specjalizacji.[9]
Zarząd określa priorytety strategiczne, ale ich przełożenie na model wymaga konfrontacji z wiedzą działu logistyki, zakupów, produkcji, HR, utrzymania ruchu oraz osób pracujących bezpośrednio na magazynie. Różnica zdań nie jest problemem do szybkiego usunięcia, lecz informacją o organizacji. Jeżeli dwa działy przypisują temu samemu kryterium zupełnie inne znaczenie, najpierw trzeba zrozumieć źródło tej rozbieżności.
Precyzyjne wartości nie zawsze są konieczne. Harju, Liesiö i Virtanen pokazują, że analizę prowadzi się również wtedy, gdy decydent potrafi jedynie określić, że jedno kryterium jest ważniejsze od drugiego albo że określony wariant jest preferowany wobec innego. Model uwzględnia wówczas zbiór dopuszczalnych preferencji zamiast wymagać jednej pozornie dokładnej tabeli wag.[10]
Dobrze zaprojektowany proces ustalania wag jest więc jednocześnie procesem poznawczym. Przekłada wiedzę organizacji na strukturę modelu, a zarazem ujawnia niejasne cele, sprzeczne interesy oraz założenia wymagające decyzji na poziomie Zarządu.
8. Analiza wrażliwości: jak zmiana założeń wpływa na rekomendację?
Wynik modelu zależy od przyjętych danych, kryteriów i ich znaczenia. Analiza wrażliwości służy do sprawdzenia, które z tych założeń rzeczywiście przesądzają o rekomendacji. Dla decydenta jest to informacja o jakości samej decyzji: wskazuje, czy przewaga danego wariantu jest wyraźna i stabilna, czy też znika po niewielkiej zmianie założeń.
Ceny energii, koszty transportu, dostępność pracowników czy wielkość produkcji zmieniają się w czasie. Zmieniają się również priorytety firmy. Jeżeli niewielka korekta znaczenia jednego kryterium całkowicie odwraca kolejność lokalizacji, rekomendacja wymaga ostrożniejszej interpretacji. Jeżeli natomiast ten sam wariant pozostaje korzystny w szerokim zakresie założeń, decyzja ma mocniejsze podstawy.
W badaniu Awasthi i współautorów przeprowadzono szereg eksperymentów, w których zmieniano znaczenie poszczególnych kryteriów. Jedna z lokalizacji pozostawała najlepsza w większości wariantów, ale przy nadaniu szczególnie dużego znaczenia kosztom przewagę uzyskiwała inna.[11] Tego rodzaju informacja jest dla decydenta często cenniejsza niż samo wskazanie pierwszego miejsca w rankingu, ponieważ pokazuje warunek, od którego zależy wybór.
Podobne testy odporności zastosowali Raad, Rajendran i Salimi, wielokrotnie zmieniając wagi i sprawdzając stabilność rezultatów.[3] W praktyce biznesowej czytelność analizy zwiększa zestawienie kilku scenariuszy odpowiadających realnym zmianom warunków: scenariusza bazowego, wysokich kosztów energii, większego znaczenia rynku pracy albo wzrostu wolumenu produkcji. Zarząd otrzymuje wtedy nie tylko rekomendację, lecz także informację, w jakich warunkach zachowuje ona aktualność.
9. Od pojedynczej analizy do systemu
Profesjonalny SDSS łączy kilka modeli, wiele źródeł danych i wspólny interfejs, w którym użytkownik przechodzi od przeglądu całego portfela do analizy pojedynczej nieruchomości.
Taką architekturę dobrze ilustrują prace Hammonda i współautorów dotyczące terenów poprzemysłowych. Opracowany przez nich system działał w środowisku WebGIS i łączył ocenę potencjalnego sposobu zagospodarowania, ryzyka gruntowego oraz danych potrzebnych do oceny ekonomicznej wykonalności przedsięwzięcia. W jednej z implementacji analizą objęto 31 942 ha terenów, a system poddano testom z udziałem profesjonalnych użytkowników.[12]
W zastosowaniach dotyczących nieruchomości przemysłowych analogiczna architektura integruje informacje o dostępności gruntów, statusie planistycznym, infrastrukturze technicznej, transporcie, rynku pracy, kosztach, możliwościach rozbudowy i parametrach rynkowych. Jej celem nie jest automatyczne wskazanie jednej „najlepszej” działki. Na wczesnym etapie większą wartość przynosi identyfikacja lokalizacji zasługujących na dalszą analizę, wskazanie brakujących danych oraz określenie, gdzie warto zaangażować czas i budżet zespołu due diligence.
Hammond i współautorzy rozwijali swój system z udziałem przyszłych użytkowników, poddawali go testom i iteracyjnie poprawiali. Podkreślają, że znajomość sposobu działania narzędzia przez użytkowników ogranicza ryzyko powstania „czarnej skrzynki” i ułatwia właściwą interpretację informacji.[8] W doradztwie dla przedsiębiorstw oznacza to, że system pozostaje zrozumiały dla osób podejmujących na jego podstawie decyzje, nawet jeśli nie znają matematyki stojącej za zastosowanymi metodami.
10. Cechy profesjonalnego SDSS
O jakości systemu wspomagania decyzji nie decyduje liczba zastosowanych algorytmów. Nawet obliczeniowo zaawansowany system pozostaje mało użyteczny, jeżeli nie odpowiada rzeczywistemu problemowi przedsiębiorstwa.
Pierwszym warunkiem jest trafne sformułowanie problemu. Użytkownik wie, jakie pytanie system pomaga rozstrzygnąć i czego nie obejmuje. Drugim jest przejrzystość: da się wskazać, które cechy lokalizacji i jakie założenia sprawiają, że dana nieruchomość jest interesująca z punktu widzenia celów biznesowych. Trzecim jest wiarygodność danych — ich pochodzenie, aktualność i adekwatność do skali analizowanego problemu.
Czwartym warunkiem jest odporność rekomendacji na realistyczne zmiany założeń. Piątym — możliwość wykorzystania systemu przez ludzi odpowiedzialnych za decyzje. Nie muszą oni znać szczegółów matematycznych, ale powinni rozumieć sens kryteriów, konsekwencje najważniejszych założeń oraz ograniczenia modelu.
Geertman i Stillwell wskazują w tym kontekście m.in. na potrzebę wiarygodności, przejrzystości, odpowiedniej rozdzielczości przestrzennej, elastyczności i prostoty, a także na kwestie walidacji i reprezentatywności danych.[2] Do tej listy w zastosowaniach przemysłowych dochodzi jeszcze jeden warunek: model pozostaje związany z wiedzą ludzi, którzy rozumieją rzeczywiste funkcjonowanie przedsiębiorstwa.
11. Wnioski
Nie istnieje jeden uniwersalny algorytm wyboru lokalizacji przemysłowej. W jednym projekcie największą wartość przynosi wstępne wykluczenie obszarów niespełniających wymagań, w innym porównanie kilku działek według wielu kryteriów, w kolejnym optymalizacja lokalizacji razem z organizacją dostaw albo analiza zachowań rynku. W dużym przedsięwzięciu kilka z tych podejść działa kolejno lub równolegle.
Właściwy proces rozpoczyna się od decyzji, którą przedsiębiorstwo chce podjąć. Trzeba ustalić cele, ograniczenia, możliwe warianty, dane oraz zakres niepewności. Następnie do pracy włącza się osoby posiadające wiedzę o faktycznym funkcjonowaniu organizacji — od Zarządu po ludzi bezpośrednio odpowiedzialnych za produkcję, logistykę, zakupy czy pracę magazynu.
Dopiero na tej podstawie dobiera się narzędzia analityczne. W tym ujęciu wartość geospatial data science nie polega na samym tworzeniu map, rankingów czy modeli. Polega na zbudowaniu przejrzystego procesu, który łączy dane z wiedzą organizacji i prowadzi do decyzji możliwej do zrozumienia, zweryfikowania i wdrożenia.
Dobrze zaprojektowany SDSS odpowiada więc nie tylko na pytanie „która lokalizacja jest najlepsza?”. Pomaga również organizacji zrozumieć, dlaczego określony wariant jest korzystny, dla kogo jest korzystny, przy jakich założeniach zachowuje przewagę oraz jakie informacje i różnice wewnątrz organizacji wpływają na tę ocenę. Wtedy system wspomagania decyzji staje się czymś więcej niż narzędziem analitycznym: staje się uporządkowanym sposobem prowadzenia rozmowy o decyzji.
Bibliografia
- Peter B. Keenan, Piotr Jankowski, Spatial Decision Support Systems: Three decades on, Decision Support Systems 116 (2019), s. 64–70. ↩
- Stan Geertman, John Stillwell, Planning support science: Developments and challenges, Environment and Planning B: Urban Analytics and City Science 47(8) (2020), w szczególności s. 1329–1334. ↩
- Nima Golghamat Raad, Suchithra Rajendran, Soheila Salimi, A novel three-stage fuzzy GIS-MCDA approach to the dry port site selection problem: A case study of Shahid Rajaei Port in Iran, Computers & Industrial Engineering 168 (2022), s. 1–4, 14. ↩
- Shahrooz Shahparvari, Araz Nasirian, Alireza Mohammadi, Sepideh Noori, Prem Chhetri, A GIS-LP integrated approach for the logistics hub location problem, Computers & Industrial Engineering 146 (2020), s. 1, 6–7. ↩
- Alan T. Murray, Richard L. Church, Xin Feng, Single facility siting involving allocation decisions, European Journal of Operational Research 284 (2020), s. 834–837. ↩
- M. A. Rahman et al., Logistics Hub Location Optimization: A K-Means and P-Median Model Hybrid Approach Using Road Network Distances, wykorzystany fragment dotyczący modelowania odległości po sieci drogowej. ↩
- Zhiwei Yang, Xiaohong Chen, Ruixu Pan, Quan Yuan, Exploring location factors of logistics facilities from a spatiotemporal perspective: A case study from Shanghai, Journal of Transport Geography 100 (2022), s. 6–8. ↩
- Ellis B. Hammond et al., The development of a novel decision support system for regional land use planning for brownfield land, Journal of Environmental Management 349 (2024), s. 5, 12. ↩
- İsmail Önden, Fahrettin Eldemir, A. Zafer Acar, Metin Çancı, A spatial multi-criteria decision-making model for planning new logistic centers in metropolitan areas, Supply Chain Analytics 1 (2023), s. 2–4. ↩
- Mikko Harju, Juuso Liesiö, Kai Virtanen, Spatial multi-attribute decision analysis: Axiomatic foundations and incomplete preference information, European Journal of Operational Research 275 (2019), s. 167–168. ↩
- Anjali Awasthi, S. S. Chauhan, S. K. Goyal, A multi-criteria decision making approach for location planning for urban distribution centers under uncertainty, Mathematical and Computer Modelling 53 (2011), s. 103–108. ↩
- Ellis B. Hammond et al., From data to decisions: Empowering brownfield redevelopment with a novel decision support system, Journal of Environmental Management 347 (2023), s. 1–2. ↩